
本地 AI 实测结果
我们在两台测试工作站上的实际速度测试:一台配两张 Radeon RX 7900 XTX,另一台配 RTX 3080 Ti 和 RTX 3080。所有模型都在我们自己的硬件上运行,启动脚本、设置和原始结果都公开在 GitHub 上。AMD 与 NVIDIA 两台测试工作站上的实测速度。
真实测试结果:AMD Radeon
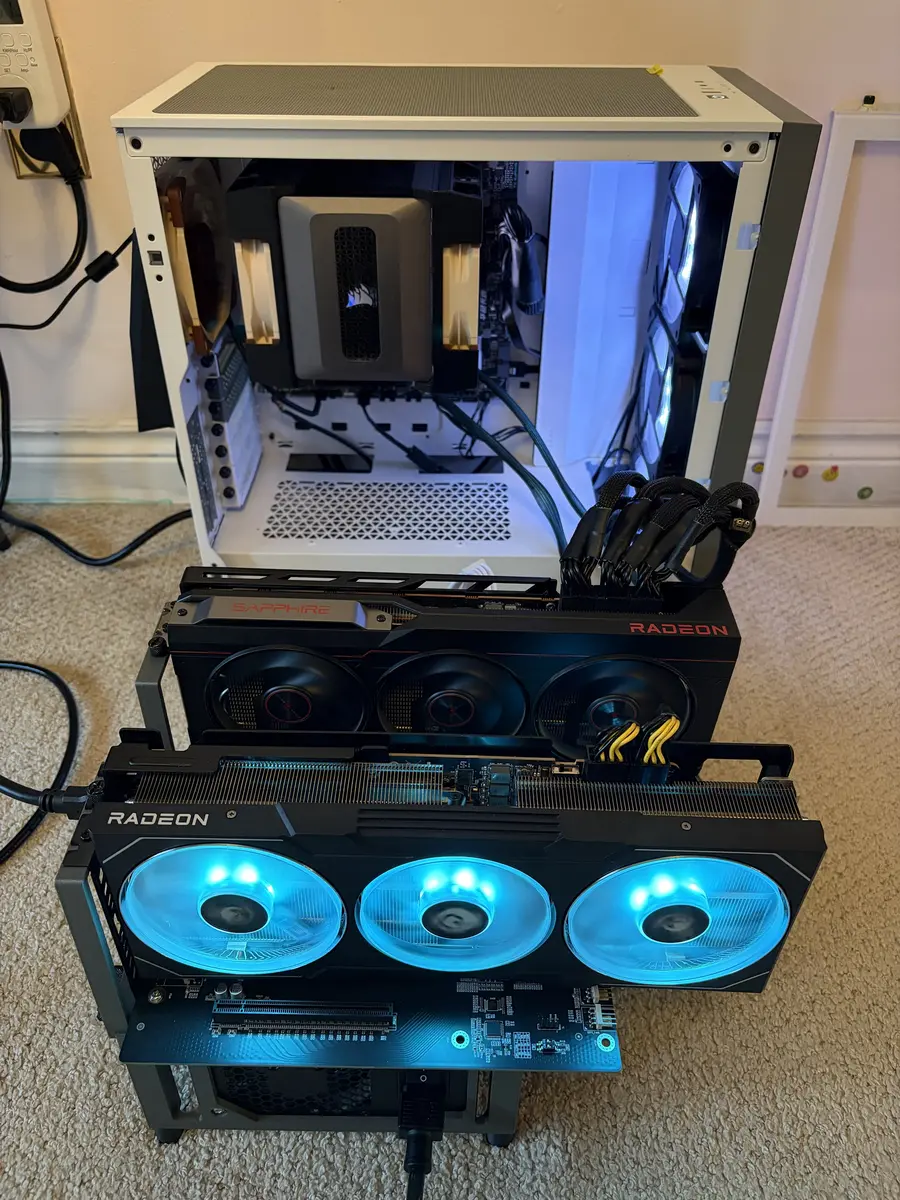
我们 AMD 工作站当前配置的最新测试结果:2026 年 11 月 9 日在最终显卡布局下的简短工具调用检查,预填充按首 token 延迟计算。启动脚本和配置已在 GitHub 公开。这是我们一次真实测试的结果示例。
两张 Radeon 显卡,48 GB 显存
Intel Core i5-13600KF、ASUS B760M 主板、64 GB DDR5 内存,搭配两张 AMD Radeon RX 7900 XTX,运行 Ubuntu。两张卡接在 Broadcom PCIe 交换芯片上,各为 x8,两卡可经交换芯片直接互传数据(测试时每个方向约 13.8 GB/s)。每个模型都拆分到两张卡上运行。i5 搭配两张接在 PCIe 交换芯片上的 Radeon RX 7900 XTX,运行 Ubuntu,每个模型同时用两张卡。
五个引擎,一个接口
SGLang 和 vLLM 运行于 ROCm,在两张卡上做张量并行;llama.cpp 运行于 HIP,承载混合专家模型;Strata 和 Maya 运行于 HIP,从固态硬盘流式加载模型;每个引擎都固定在经过测试的版本。一次只运行一个引擎,前面是带身份验证的 OpenAI 兼容网关,会按请求中的模型名启动或切换,所以同一套聊天和智能体工具可以使用所有模型。SGLang、vLLM、llama.cpp、Strata 和 Maya 分布在两张卡上,一次一个,统一走带身份验证的接口,按需加载模型。
Empero 每秒 173 token,256K 上下文
Empero 是完全放在显存里的混合专家模型,在当前配置上以 256K 上下文达到每秒 173 个 token。这套配置上共有 9 个模型配置通过验证:SGLang 和 vLLM 上的 Qwen3.8-27B、Nemotron Bolt 和 Ripple-65B 完全放在显存里,Strata 和 Maya 从固态硬盘流式加载 Qwen3.8-Flash-Next、DeepSeek V4.1 Flash 和 GLM-5.3-Flash。当前配置上 Empero 每秒 173 token,256K 上下文,9 个模型配置通过验证。
| 模型 / 量化 | 引擎 | 上下文 | 预填充 t/s | 首 token 延迟 | 解码 t/s |
|---|---|---|---|---|---|
| 全部放入显存的模型 | |||||
| Qwen3.8-27B | |||||
| INT4工具调用 | SGLang TP2 + DFlash2 | 160K | 1,736输入 ÷ 首 token 延迟 | 3.86 s | 211.2 |
| INT4工具调用 | vLLM TP2 | 160K | 1,766输入 ÷ 首 token 延迟 | 3.64 s | 155.1 |
| llama.cpp | |||||
| Empero Qwen3.8-35B-A3B IQ4_XS工具调用 | llama.cpp HIP + MTP3 | 256K | 2,893输入 ÷ 首 token 延迟 | 2.22 s | 173.3 |
| vLLM | |||||
| Nemotron 3.5 Bolt 74B AutoRound W4A16工具调用 | vLLM TP2 + Triton int4 MoE | 256K | 1,963输入 ÷ 首 token 延迟 | 3.55 s | 40.1 |
| Ripple-65B Preview GPTQ W4A16工具调用 | vLLM TP2 | 64K | 764输入 ÷ 首 token 延迟 | 8.18 s | 28.0 |
| 从固态硬盘流式加载的 MoE 模型 | |||||
| Strata | |||||
| Qwen3.8-Flash-Next IQ3_XXS工具调用 | Strata HIP + MTP | 256K | 740输入 ÷ 首 token 延迟 | 8.38 s | 86.3 |
| DeepSeek V4.1 Flash 1017 | |||||
| UD-IQ1_S工具调用 | Maya HIP | 32K | 35输入 ÷ 首 token 延迟 | 182.22 s | 6.8 |
| UD-IQ1_S工具调用 | Strata HIP | 32K | 111输入 ÷ 首 token 延迟 | 57.21 s | 5.6 |
| Maya | |||||
| GLM-5.3-Flash IQ2_XXS工具调用 | Maya HIP | 32K | 57输入 ÷ 首 token 延迟 | 105.75 s | 5.2 |
质量排名
| 模型 / 量化 | 排名 | 得分(95% 区间) | 代码 (20) | 指令遵循 (32) | 知识 (60) | 数学 (40) | 推理 (32) | 工具调用 (32) |
|---|---|---|---|---|---|---|---|---|
| Qwen3.8-Flash-Next IQ3_XXSStrata(RDNA3 分支) | 1 | 78.2%72.3–83.2% | 12 | 30 | 48 | 33 | 23 | 23 |
| DeepSeek V4.1 Flash 1017 UD-IQ1_SMaya | 2 | 77.8%71.8–82.8% | 12 | 28 | 51 | 29 | 22 | 26 |
| Qwen3.8-27B INT4SGLang | 3 | 75.5%69.3–80.7% | 8 | 31 | 47 | 32 | 18 | 27 |
| Empero Qwen3.8-35B-A3B IQ4_XSllama.cpp | 4 | 69.9%63.5–75.6% | 11 | 25 | 47 | 24 | 16 | 28 |
| Nemotron 3.5 Bolt 74B AutoRound W4A16vLLM | 5 | 66.2%59.7–72.2% | 7 | 23 | 46 | 30 | 15 | 22 |
| GLM-5.3-Flash IQ2_XXSMaya | 6 | 63.0%56.3–69.1% | 10 | 25 | 43 | 11 | 21 | 26 |
| Ripple-65B Preview GPTQ W4A16vLLM | 7 | 62.0%55.4–68.2% | 5 | 17 | 42 | 32 | 14 | 24 |
| 测试配置 | |
|---|---|
| 处理器 | Intel Core i5-13600KF |
| 主板 | ASUS TX GAMING B760M WIFI |
| 内存 | 64 GB DDR5(可用 61.6 GiB) |
| 显卡 | 2 张 AMD Radeon RX 7900 XTX,每张 24 GB(共 48 GB) |
| 显卡连接 | 两张卡接在 Broadcom PEX88096 PCIe 交换芯片上,各为 x8(上行 Gen4 x16);已开启显卡直连传输,测试时每个方向约 13.8 GB/s |
| 电源 | 两台电源:一台为 PCIe 交换板和两张显卡供电,另一台为系统其余部分供电 |
| 模型存储 | NVMe 和 SATA 固态硬盘 |
| 操作系统 | Ubuntu,Linux 内核 7.0 |
| GPU 软件 | ROCm 7.2.3(HIP) |
| 结果测得时的配置 | Qwen3.8-Flash-Next:2026 年 11 月 18 日在 Strata RDNA3 分支上测得,专家不设固定内存预算。其余各行均为当前配置(11 月 7 日的显卡布局),2026 年 11 月 9 日测得,各一次简短工具调用请求,已开启显卡直连传输(GLM-5.3-Flash 加载期间使用较长的看门狗间隔) |
测试方法
- 每次只加载一个模型,分布在两张显卡上。所有数据均不含模型加载和预热运行。
- 每一行都采用当前配置上最新的一次测试。最新测试未测量的数值,取当前配置上较早一次的最新结果,并注明日期。
- 预填充和首 token 延迟(11 月 9 日):通过正常接口发送一次真实的工具调用请求,约 5,900 至 7,000 个输入 token,包含 25 个工具定义。客户端只记录首 token 延迟(从发送请求到收到第一段内容,包含工具调用解析)和请求总时间,因此预填充按输入 ÷ 首 token 延迟计算。
- 解码(11 月 9 日):工具调用回复的输出 token 数除以从第一个 token 到请求结束的时间。回复是一次约 54 至 171 个 token 的工具调用,因此反映的是短时突发速度,而非持续速度。
- 上下文为已安装配置所设定的窗口。
- 已通过的检查:工具调用指模型通过正常接口完成了一次工具往返调用和后续回答。
- 自 2026 年 11 月 9 日起,引擎更新改为每天检查并人工安装,不再由每晚更新程序完成:只要新版本没有真正出问题(工具调用检查失败、崩溃、速度低于现有水平的一半,或首 token 延迟超过三倍),就会采用。
NVIDIA 硬件与测试结果
当前硬件 · Ubuntu:RTX 3080 Ti + RTX 3080,共 22 GB 显存
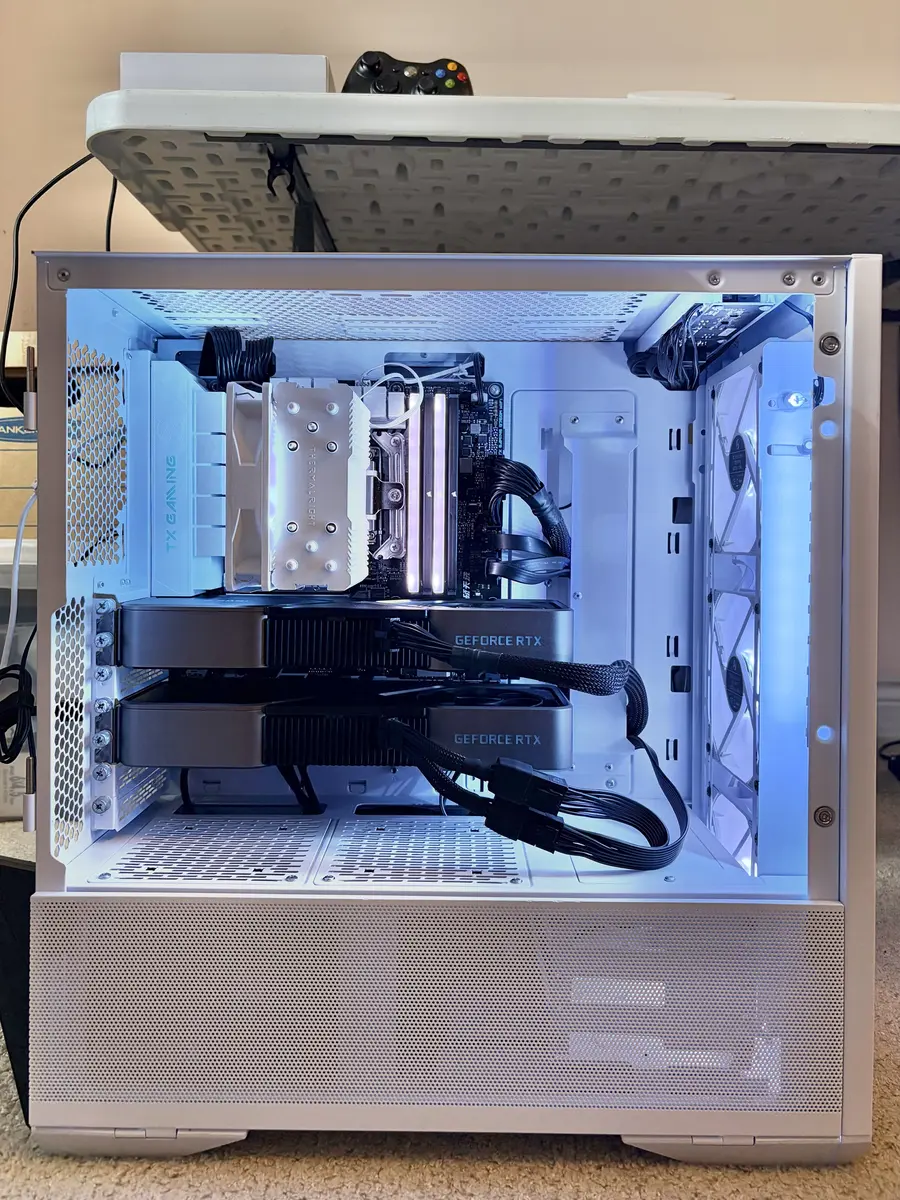
我们的 NVIDIA 测试工作站。下方所有结果均于 2026 年 11 月 5 日至 6 日在现在的 96 GB 内存配置上测得。我们的 NVIDIA 测试工作站。
两张 GeForce 显卡,共 22 GB 显存
Intel Core i9-13900KS、MSI Z690 主板、96 GB DDR5 内存,运行 Ubuntu 26.04 和 NVIDIA 615 驱动。RTX 3080 Ti 12 GB 和 RTX 3080 10 GB 各自以 PCIe 4.0 x8 直连 CPU,两卡没有直连通道,显示由处理器集成显卡负责。大多数模型配置都把模型分配在这两张卡上。i9、96 GB 内存,RTX 3080 Ti 和 RTX 3080,运行 Ubuntu。
五个引擎,一个接口
HyperQwen(基于 vLLM)和 SGLang 运行完全放在显存里的 Qwen3.8-27B;llama.cpp、Strata 和 Maya 运行混合专家模型,专家从系统内存和固态硬盘读取。模型路由器通过带身份验证的 OpenAI 兼容接口对外服务,一次加载一个模型。HyperQwen、SGLang、llama.cpp、Strata 和 Maya,一次一个模型,统一走带身份验证的接口。
22 GB 显存,最高每秒 84 token
Strata 从固态硬盘流式加载 Qwen3.8-Flash-Next 的 IQ3_XXS 版本,以 128K 上下文达到每秒 84 个 token。Nemotron Bolt 使用 NVIDIA 原生 2 bit 版本、部分放在系统内存中,以 160K 上下文达到每秒 68 个 token,HyperQwen 把 4 bit 的 Qwen3.8-27B 完全放进显存,以 84K 上下文达到每秒 63 个 token。从固态硬盘流式加载最高每秒 84 token,Bolt 每秒 68 token,完全放在显存里每秒 63 token。
| 模型 / 量化 | 引擎 | 上下文 | 预填充 t/s | 首 token 延迟 | 解码 t/s |
|---|---|---|---|---|---|
| 全部放入显存的模型 | |||||
| Qwen3.8-27B | |||||
| AutoRound INT4工具调用 | HyperQwen vLLM TP2 | 84K | 2,094.6 | 2.80 s | 62.7 |
| AutoRound INT4工具调用 | SGLang TP2 | 56K | 2,130.1 | 2.90 s | 60.12 |
| 部分放在系统内存的模型 | |||||
| llama.cpp | |||||
| Nemotron 3.5 Bolt 74B native IQ2工具调用 | llama.cpp CUDA | 160K | 673.8 | 9.60 s | 67.8 |
| 从固态硬盘流式加载的 MoE 模型 | |||||
| Qwen3.8-Flash-Next | |||||
| IQ3_XXS工具调用 | Strata CUDA | 128K | 1,058.0 | 5.40 s | 83.7 |
| UD-IQ4_XS-v31工具调用 | Strata CUDA | 128K | 759.9 | 7.63 s | 43.7 |
| Maya | |||||
| GLM-5.3-Flash IQ2_XXS工具调用 | Maya CUDA | 64K | 550.9 | 10.06 s | 14.2 |
| DeepSeek V4.1 Flash 1017 | |||||
| UD-IQ1_S工具调用 | Strata CUDA | 32K | 87.1 | 65.59 s | 12.00 |
| UD-IQ1_S工具调用 | Maya CUDA | 32K | 209.4 | 28.84 s | 8.3 |
质量排名
| 模型 / 量化 | 排名 | 得分(95% 区间) | MMLU-Pro | AIME 2025 | LiveCodeBench | BFCL 单轮 | BFCL 多轮 |
|---|---|---|---|---|---|---|---|
| DeepSeek V4.1 Flash 1017 UD-IQ1_SStrata | 1 | 73.0%67.3–78.4% | 86.7% | 76.7% | 55.0% | 90.0% | 56.7% |
| Qwen3.8-27B AutoRound INT4SGLang | 2 | 68.1%62.3–73.9% | 85.7% | 66.7% | 50.0% | 91.7% | 46.7% |
| Qwen3.8-Flash-Next UD-IQ4_XS-v31Strata | 3 | 65.5%60.2–70.8% | 87.6% | 80.0% | 58.3% | 78.3% | 23.3% |
| Qwen3.8-Flash-Next IQ3_XXSStrata | 4 | 62.0%56.5–67.5% | 85.2% | 73.3% | 58.3% | 73.3% | 20.0% |
| GLM-5.3-Flash IQ2_XXSMaya | 5 | 57.2%52.1–62.3% | 86.2% | 6.7% | 55.0% | 91.7% | 46.7% |
| Nemotron 3.5 Bolt 74B native IQ2llama.cpp | 6 | 53.9%48.7–59.4% | 76.2% | 50.0% | 33.3% | 90.0% | 20.0% |
| 测试配置 | |
|---|---|
| 处理器 | Intel Core i9-13900KS,集成显卡负责显示 |
| 主板 | MSI MPG Z690 Carbon WiFi |
| 内存 | 96 GB DDR5(可用约 91.8 GiB) |
| 显卡 | NVIDIA GeForce RTX 3080 Ti 12 GB + RTX 3080 10 GB(共 22 GB) |
| 显卡连接 | 每张卡各自以 PCIe 4.0 x8 直连 CPU;两卡没有直连通道,数据经系统内存交换 |
| 模型存储 | 流式加载的模型放在 NVMe 系统盘;Qwen3.8-27B、Nemotron Bolt 和部分 DeepSeek 放在 Samsung 870 QVO SATA 固态硬盘 |
| 操作系统 | Ubuntu 26.04,Linux 内核 7.0 |
| GPU 软件 | NVIDIA 驱动 615.71.09,原厂功耗限制 |
| 结果测得时的配置 | HyperQwen:2026 年 11 月 9 日升级到 vLLM 0.33.0 后。Qwen3.8-Flash-Next:11 月 16 日升级到 Strata 0.2.15 后。Qwen3.8-Flash-Next UD-IQ4_XS-v31:11 月 18 日,重新加载后的第一个请求,Strata 引擎相同。Maya 上的 GLM 和 DeepSeek:11 月 18 日升级到 Maya 1.1.67 后。Nemotron Bolt:11 月 13 日升级到 llama.cpp 1.0.0 后,使用内存提示缓存。SGLang 和 Strata 上的 DeepSeek:11 月 5 日全部模型重新测试时。均为现在的 96 GB 内存配置 |
测试方法
- 每次只加载一个模型,分布在两张显卡上。不含模型加载时间,也不清空操作系统的文件缓存。
- 每一行为通过正常接口发送的一次真实工具调用请求,约 5,400 至 6,400 个输入 token、几十个输出 token,并带一次精确的后续回答;我们保留成功运行中最快的一次。
- 预填充和解码取引擎自身计数;首 token 延迟从发送请求计到收到第一段内容,包含工具调用解析。
- 上下文为已安装配置使用的窗口。
- 已通过的检查:工具调用指模型通过正常接口完成了一次工具往返调用和精确的后续回答。
- 自 2026 年 11 月 9 日起,引擎更新改为每天检查并人工安装,不再由每晚更新程序完成:每个新版本先单独准备,在切换前后用同样的简短工具调用测试检查,只要没有真正出问题(检查失败、速度低于现有水平的一半,或首 token 延迟超过三倍)就保留。
图像与视频生成
在 AMD 与 NVIDIA 工作站上用 ComfyUI 实测的图像与视频扩散模型:Qwen-Image、FLUX 3 Image Klein、MiniMax H3、Wan 2.2 和 LTX 2.3。用 ComfyUI 实测的图像与视频模型。
想把大模型装到自己的设备上?
说说您现有的设备、想用的模型和要解决的问题,我们会为您规划合适的本地部署方案。